AI-конвейер для извлечения данных из счетов и документов
(n8n & OpenRouter)
Обзор проекта
Автоматизированный локальный конвейер обработки документов и счетов, созданный для полного исключения ручного ввода данных. Система непрерывно мониторит почтовый ящик, интеллектуально маршрутизирует вложения в зависимости от их формата, извлекает структурированную финансовую информацию с помощью мультимодальных ИИ-моделей, очищает и нормализует данные через скрипты, после чего обновляет локальный HTML-реестр.
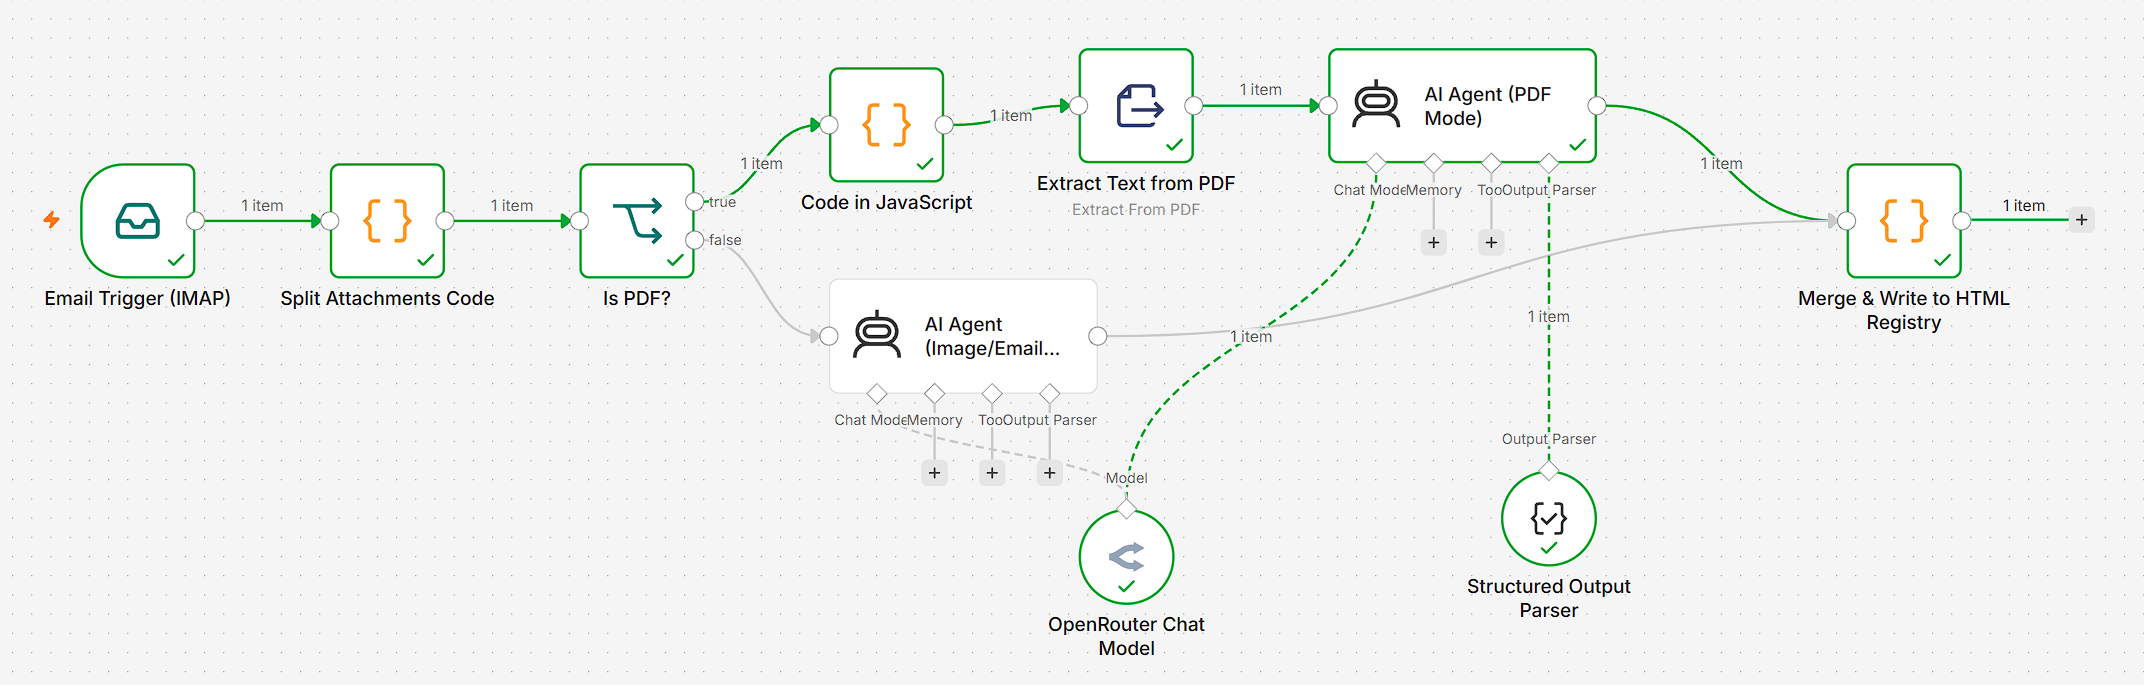
Пошаговая архитектура и реализация
Шаг 1: Почтовый триггер (Email Trigger IMAP)
- Что делает: Рабочий процесс запускается автоматически через IMAP-триггер, который в реальном времени отслеживает входящие сообщения.
- Технические детали: Настроено безопасное подключение к почтовому серверу для перехвата писем с вложениями (цифровые счета или фотографии чеков) и передачи их в дальнейший пайплайн.
Step 2: Разделение и нормализация вложений (Split Attachments Code)
- Что делает: Письма часто содержат несколько файлов или второстепенные элементы (например, логотипы компании или подписи). Этот кастомный JavaScript-узел изолирует каждое вложение отдельно.
- Технические детали: Извлекаются бинарные буферы файлов, отфильтровываются ненужные элементы, а метаданные приводятся к единому стандарту, чтобы каждый файл шел по конвейеру в виде чистого потока данных.
Шаг 3: Условное ветвление по форматам (Is PDF?)
- Что делает: Определяет, является ли входящий файл структурированным PDF-документом или изображением (JPEG, PNG и т. д.).
- Технические детали: Используется условный узел-разветвитель (Switch), разделяющий пайплайн на два оптимизированных параллельных пути:
- Ветвь True (PDF): Направляет текстовые документы на этап выделения текста.
- Ветвь False (Изображения/Email): Перенаправляет визуальные файлы напрямую мультимодальному ИИ-агенту.
Шаг 4: Извлечение текста против мультимодальной обработки
- Для PDF: Файл проходит через узел Extract Text from PDF для эффективного извлечения «сырого» текста перед отправкой в текстовый ИИ-агент.
- Для изображений: Файл минует этап извлечения текста и поступает напрямую в мультимодальный ИИ-агент, способный анализировать документ визуально (OCR + глубокое понимание контекста).
Шаг 5: ИИ-экстракция данных (AI Agent & Structured Output Parser)
- Что делает: Превращает неструктурированные документы в строго типизированные JSON-данные.
- Технические детали:
- Работает на базе эффективных LLM через OpenRouter Chat Model.
- Интегрирован со Structured Output Parser (парсером структурированного вывода), который жестко фиксирует схему ответа.
- ИИ-агент точно распознает и извлекает ключевые финансовые поля: номер счета, дату, имя поставщика, список позиций, количество и итоговую сумму.
Шаг 6: Очистка данных, нормализация и защита от дубликатов (Merge & Write to HTML Registry)
- What it does: Объединяет параллельные потоки выполнения, предотвращает создание дубликатов и подготавливает данные для сохранения.
- Technical details:
- Слияние веток: Соединяет результаты обработки PDF и изображений обратно в единый поток.
- Нормализация цен: Кастомный JS-код удаляет символы валют, заменяет запятые на точки и приводит цены к числу с фиксированными двумя знаками после запятой (например, 145.00), обеспечивая корректную сортировку.
- Проверка на дубликаты: Сравнивает новые записи с уже существующими в реестре по уникальному составному ключу (Дата + Номер счета + Сумма), исключая повторные записи.
- Генерация HTML и сортировка: Автоматически сортирует записи в хронологическом порядке и обновляет локальный автономный файл
invoice.html, в который встроен скрипт интерактивной сортировки таблиц на стороне клиента (позволяет кликать на любую шапку столбца для сортировки).
Технологический стек
n8n (Self-hosted / Local-first)
Docker
Claude Code
OpenRouter API
Multimodal LLMs
Structured Output Parsers
JavaScript (Node.js)
IMAP
HTML5 / CSS3